导语
在信息爆炸的时代,“猜对”已经不再是一种赋能,而是可以被量化的技术。预测建模(Predictive Modeling)正是这样一门将“经验”转化为“算法”的学问,它让金融机构提前识别欺诈交易,让医院预判病患风险,也让气象学家更准确地描绘明天的天气。
什么是预测建模?
简单来说,预测建模就是用过去的数据来推断未来的可能性。它不是占卜,而是建立在概率论与统计推断基础之上的一套方法论。模型会从海量历史记录中找出潜在规律,然后将这些规律套用到新场景中,给出概率化的预测结果。
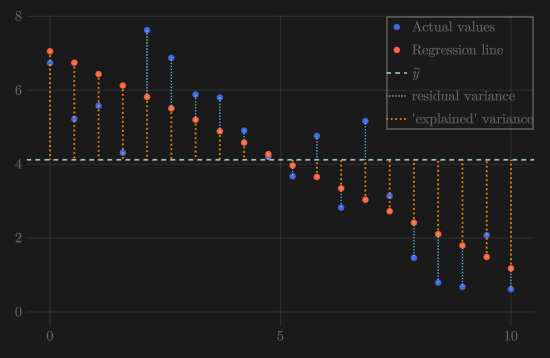
最常见的入门例子是线性回归。假设我们想预测房价(y)与面积(x)之间的关系,模型会表达为 y = β₀ + β₁x + ε。其中β₀是截距,β₁是斜率,ε则代表实际值与预测值之间的误差。通过最小化误差,模型会自动学习出最佳参数,从而形成一条能“拟合”现实的直线。
从理论到代码:一个最小可运行示例
在Python中,借助scikit-learn库,一个简单的线性回归只需几行代码:
``` import numpy as np from sklearn.linear_model import LinearRegression # 生成示例数据 X = np.array([1, 2, 3, 4, 5]).reshape((-1, 1)) y = np.array([2, 3, 5, 7, 11]) # 创建并训练模型 model = LinearRegression() model.fit(X, y) # 输出结果 print("R²:", model.score(X, y)) print("截距:", model.intercept_) print("斜率:", model.coef_) ```
这段代码背后的逻辑很清晰:模型通过最小化均方误差(MSE)来找到最优参数。R²值越接近1,说明模型对数据的解释力越强。当然,现实世界的数据很少如此“听话”,通常需要更复杂的模型——比如决策树、随机森林,甚至深度神经网络。
1. 金融:从“后知后觉”到“风控前置”
在银行与保险领域,预测建模的最成熟应用之一是信用评分。传统方式依赖人工审核与固定规则,而现代模型则能汇集几千个变量——从工资水平、消费习惯到社交网络行为——在几秒钟内生成风险评估。更重要的是,它能持续学习新的欺诈手段,让风控系统始终跑在风险前面。
2. 医疗:精准医疗的基础设施
预测建模正在改变医疗的“治已病”逻辑。通过分析患者的电子病历、基因检测和生活方式数据,医院可以在疾病发生前就识别高危人群,提前干预。比如,某些系统已能提前48小时预测急性肾损伤风险,让医生有更多时间制定方案。
3. 气候科学:看清未来的天空
全球气候变化让长期天气预报变得更加重要。气象学家利用历史气候数据训练模型,预测未来数周甚至数月的降雨量与温度变化。这些预测不仅帮助农业决定种植时间,也为政府的灾害应对提供了科学依据。
模型好不好,谁说了算?
有了模型还不够,关键在于如何判断它是不是“乱猜”。常用的评估指标包括:
- MSE(均方误差):误差越小越好,但对异常值敏感。
- MAE(平均绝对误差):更耐心的评估方式,对极端值不那么敏感。
- R²(决定系数):衡量模型解释了多少数据变异,接近1表示拟合度很高。
但这些指标都有一个共同缺陷:它们只能告诉你模型在已见数据上表现如何,却无法保证在未见数据上也能维持同样水平。为此,交叉验证(Cross-Validation)成为标准做法。它把数据切成多份,轮流用其中一份作为测试集,剩下的作为训练集,最终取平均表现来评估模型稳健性。
常见陷阱:过拟合与偏见
预测建模最大的敌人不是算法本身,而是过拟合(Overfitting)。当模型记住了训练数据中的噪声而非规律时,它在新数据上的表现会很差。解决方案包括增加数据量、简化模型结构,或使用正则化(Regularization)技术给模型“浇水”。
另一个常被忽视的问题是数据偏见。如果历史数据本身就包含歧视(比如某些地区的贷款记录天然少于其他地区),模型会将这种偏见“学习”下来,并在预测时加以放大。因此,数据清洗与偏见审查应该成为建模流程中不可或缺的一环。
结语
预测建模不是魔法,它只是一套让决策更有结构、更少盲目的工具。它的力量在于“大数据 + 算法 + 领域知识”的三者结合。对普通人来说,理解它的原理与局限,比追求“最先进的算法”更有实际价值——因为最好的模型,始终是那个能被解释、被信任、并且真正解决问题的模型。